Domain unternehmenszentrum.de kaufen?
Wir ziehen mit dem Projekt
unternehmenszentrum.de um.
Sind Sie am Kauf der Domain
unternehmenszentrum.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain unternehmenszentrum.de kaufen?
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **


Ähnliche Suchbegriffe für Datenquellen
Top-Angebote
Produkte zum Begriff Datenquellen:
-
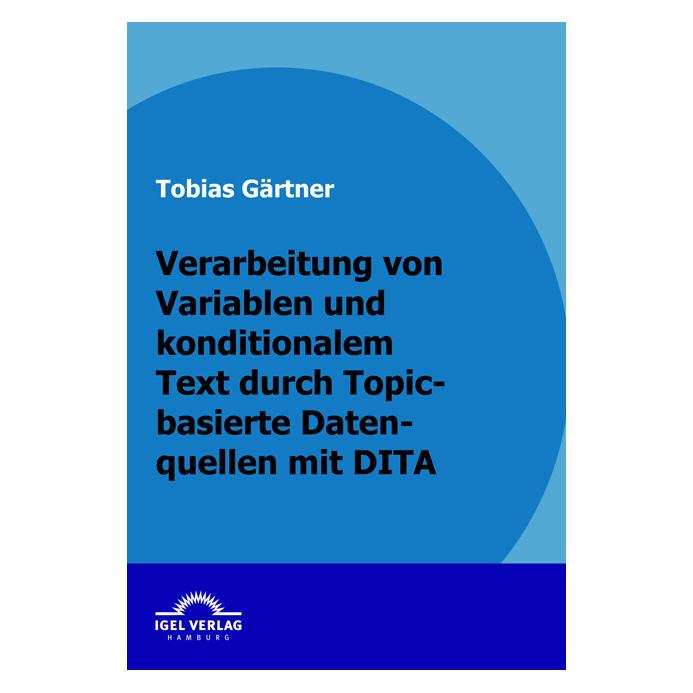
Igel Records Verarbeitung von Variablen und konditionalen Text durch Topic-basierte Datenquellen mit DITA (Deutsch, Softcover, Tobias Gärtner) (8290455)Igel Records Verarbeitung von Variablen und konditionalen Text durch Topic-basierte Datenquellen mit DITA (Deutsch, Softcover, Tobias Gärtner) (8290455)39,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Eine Studie zu Microarray-Datenquellen und deren Verwaltung, Taschenbuch von Chirag Patel,Himanshu Pandya,Devarshi Mehta, Verlag Unser WissenEine Studie Zu Microarray-datenquellen Und Deren Verwaltung, Taschenbuch Von Chirag Patel,himanshu Pandya,devarshi Mehta, Verlag Unser Wissen, Seitenanzahl: 9666,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Verarbeitung von Variablen und konditionalen Text durch Topic-basierte Datenquellen mit DITA, Taschenbuch von Tobias Gärtner, Igel Verlag Literatur &Verarbeitung Von Variablen Und Konditionalen Text Durch Topic-basierte Datenquellen Mit Dita, Taschenbuch Von Tobias Gärtner, Igel Verlag Literatur & Wissenschaft, 978-3-86815-235-7, Seitenanzahl: 7639,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **

Was sind die gängigsten Programmierschnittstellen zum Zugriff auf externe Datenquellen?
Die gängigsten Programmierschnittstellen zum Zugriff auf externe Datenquellen sind RESTful APIs, SOAP APIs und ODBC/JDBC. RESTful APIs sind leicht zu implementieren und weit verbreitet, SOAP APIs bieten eine standardisierte Kommunikationsschnittstelle und ODBC/JDBC ermöglichen den Zugriff auf relationale Datenbanken. **
Wie können verschiedene Datenquellen effizient miteinander abgeglichen und synchronisiert werden?
Durch die Verwendung von Datenintegrations-Tools können verschiedene Datenquellen miteinander verbunden und synchronisiert werden. Diese Tools ermöglichen es, Daten aus verschiedenen Quellen zu extrahieren, zu transformieren und zu laden, um konsistente und aktuelle Informationen zu gewährleisten. Automatisierte Prozesse können dabei helfen, den Abgleich und die Synchronisierung effizient durchzuführen. **
Top-Angebote
Produkte zum Begriff Datenquellen:
-
Herausforderung im effizienten Umgang mit Daten unter Berücksichtigung von unterschiedlichen Datenquellen, Taschenbuch von Hans Schätzle, GRIN,Herausforderung Im Effizienten Umgang Mit Daten Unter Berücksichtigung Von Unterschiedlichen Datenquellen, Taschenbuch Von Hans Schätzle, Grin, 978-3-346-59698-7, Seitenanzahl: 3617,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Igel Records Verarbeitung von Variablen und konditionalen Text durch Topic-basierte Datenquellen mit DITA (Deutsch, Softcover, Tobias Gärtner) (8290455)Igel Records Verarbeitung von Variablen und konditionalen Text durch Topic-basierte Datenquellen mit DITA (Deutsch, Softcover, Tobias Gärtner) (8290455)39,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Eine Studie zu Microarray-Datenquellen und deren Verwaltung, Taschenbuch von Chirag Patel,Himanshu Pandya,Devarshi Mehta, Verlag Unser WissenEine Studie Zu Microarray-datenquellen Und Deren Verwaltung, Taschenbuch Von Chirag Patel,himanshu Pandya,devarshi Mehta, Verlag Unser Wissen, Seitenanzahl: 9666,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
-
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **
-
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Ähnliche Suchbegriffe für Datenquellen
-
Verarbeitung von Variablen und konditionalen Text durch Topic-basierte Datenquellen mit DITA, Taschenbuch von Tobias Gärtner, Igel Verlag Literatur &Verarbeitung Von Variablen Und Konditionalen Text Durch Topic-basierte Datenquellen Mit Dita, Taschenbuch Von Tobias Gärtner, Igel Verlag Literatur & Wissenschaft, 978-3-86815-235-7, Seitenanzahl: 7639,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Büromöbel Chefzimmer Rimmi komplette BüroausstattungKomplette Büroausstattung Rimmi, Büromöbel Chefzimmer Dieses repräsentative Büromöbel ist der schnellste Weg, ein individuelles Chefzimmer komplett auszustatten. Die exklusive Seite dieser kompletten Büroausstattung kommt insbesondere auf der Führungsetage zum Tragen. Standardausstattung: + Schreibtisch mit Melaminbeschichtung. + Tischplatte ca. 180 x 90 cm. + Kabelauslass und Box für Steckdosenleiste. + Container mit zwei Schubladen und einem Fach. + Container frei positionierbar. + Büroregal in 5 OH (Ordnerhöhen). + 5 Jahre Herstellergarantie. Maße Schreibtisch: Höhe: ca. 75 cm Breite: ca. 180 cm Tiefe: ca. 90 cm Maße Container: Höhe: ca. 52 cm Breite: ca. 90 cm (120 cm) Tiefe: ca. 60 cm Maße Büroregal: Höhe: ca. 195 cm Breite: ca. 270 cm Tiefe: ca. 40 cm Lieferung: Büromöbel Chefzimmer Rimmi komplette Büroausstattung wird zerlegt ausgeliefert. Die Lieferung erfolgt frei Bordsteinkante. Optional deutschlandweit (außer Inseln, Lieferzeit + 2 Wochen): + Lieferung inkl. Vertragen, Montage Service, Ensorgung der Verpackung Dieses Produkt besteht aus 14 Paketen. Gewicht: ca. 359,9 kg. Tischplatte: 182x5,6x92 cm, ca. 39,0 kg Box für Steckdosen: 14x20x47 cm, ca. 2,5 kg Gestell: 92x74x8 cm, ca. 14,8 kg Gestell: 74x70x92 cm, ca. 20,0 kg Container (vormontiert): 92x62x54 cm, ca. 59,5 kg 3 × Oberteil, Unterteil, Einlegeboden und Trennwände: 92x10x40 cm, ca. 23,1 kg 3 × Einlegeböden und Trennwände: 92x12x40 cm, ca. 26,8 kg 3 × Rückwand: 195x92x4 cm, ca. 24,5 kg Aufbauanleitung: Schreibtisch Rimmi Box für Steckdosen (Schreibtisch) Container (Schreibtisch) Regal Qualitätsprodukt vom führenden Anbieter.2931,18 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Logitech GROUP - ConferenceCam für mittelgroße & große KonferenzräumeHD-Videoqualität in 1080p mit 30 Bildern pro Sekunde / 90°-Sichtfeld mit mechanischer 260°-Schwenk- & 130°-Neigefunktion / Verlustfreier 10-fach-HD-Zoom / Full-Duplex-Freisprecheinrichtung / Kompatibel mit Mac® und PC532,46 €*Versand: 6,99 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
-
Was sind die gängigsten Programmierschnittstellen zum Zugriff auf externe Datenquellen?
Die gängigsten Programmierschnittstellen zum Zugriff auf externe Datenquellen sind RESTful APIs, SOAP APIs und ODBC/JDBC. RESTful APIs sind leicht zu implementieren und weit verbreitet, SOAP APIs bieten eine standardisierte Kommunikationsschnittstelle und ODBC/JDBC ermöglichen den Zugriff auf relationale Datenbanken. **
-
Wie können verschiedene Datenquellen effizient miteinander abgeglichen und synchronisiert werden?
Durch die Verwendung von Datenintegrations-Tools können verschiedene Datenquellen miteinander verbunden und synchronisiert werden. Diese Tools ermöglichen es, Daten aus verschiedenen Quellen zu extrahieren, zu transformieren und zu laden, um konsistente und aktuelle Informationen zu gewährleisten. Automatisierte Prozesse können dabei helfen, den Abgleich und die Synchronisierung effizient durchzuführen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.